

Los archivos Agent Discovery Files y llms.txt describen una configuración práctica de los archivos AI Discovery Files: llms.txt puede proporcionar a los modelos de lenguaje información sobre el contenido importante del sitio web, mientras que ADF, como enfoque arquitectónico de Berger+Team, agrupa información legible por máquina sobre la identidad, la marca, las preguntas frecuentes, los avisos de derechos de autor, el catálogo de conocimientos y los puntos finales de la API.
Es importante comprender el contexto: llms.txt es actualmente una convención o propuesta, no un estándar oficial como los estándares ratificados del W3C o la IETF. Este archivo no reemplaza el SEO, los datos estructurados de tu sitio web ni una arquitectura de información clara. Según la página de la propuesta de llms.txt de Jeremy Howard, se trata de un archivo Markdown sugerido que proporciona información compatible con LLM. Puedes encontrar la fuente al final de este artículo.
Los archivos de descubrimiento no constituyen un mecanismo de control para las respuestas de la IA. Pueden proporcionar orientación, mejorar la interpretabilidad de las máquinas y transparentar la gobernanza. Sin embargo, los archivos de descubrimiento no garantizan la citación en ChatGPT, Google AI Overviews ni en otras respuestas de IA.
Escribo esta guía basándome en mi experiencia práctica trabajando con pymes en Bolzano, Tirol del Sur y la región DACH (Alemania, Austria y Suiza). En más de 20 años de experiencia en branding, desarrollo web y estrategia digital, he aprendido que las pequeñas empresas no necesitan complejidad técnica adicional. Necesitan un sistema fácil de entender que explique claramente su marca, servicios, ubicaciones, opciones de contacto y derechos, tanto para personas como para motores de búsqueda y, cada vez más, para agentes de IA.
Archivos de descubrimiento de agentes y llms.txt: ¿Qué hacen los archivos de descubrimiento?
llms.txt es un archivo de texto en el directorio raíz de un sitio web, generalmente en /llms.txtEl archivo permite organizar páginas importantes, documentación, áreas de servicio o preguntas frecuentes de forma que los modelos de lenguaje y las herramientas puedan acceder más rápidamente a la estructura del sitio web. El objetivo es la orientación, no el control.
Los Archivos de Descubrimiento de Agentes ( ADF , por sus siglas en inglés ) no son un estándar industrial generalmente aceptado para nosotros. ADF es un enfoque arquitectónico de Berger+Team : un conjunto de archivos e interfaces legibles por máquina que le da a un sitio web una identidad más clara y comprensible para las máquinas. Utilizo ADF como un patrón arquitectónico, no como un estándar.
Una configuración de ADF puede contener, por ejemplo, los siguientes componentes:
- Expedientes de identidad: Nombre de la empresa, ubicación, forma jurídica, persona de contacto, idiomas, región y áreas de servicio.
- Archivos de marca: Posicionamiento, tono de voz, valores, grupos objetivo, exclusiones y reglas de comunicación.
- Archivos de preguntas frecuentes: Preguntas frecuentes con respuestas claras y coherentes con el contenido del sitio web.
- Archivos de derechos y uso: Instrucciones sobre cómo se debe usar, citar o no usar el contenido.
- Puntos finales de la API: Acceso estructurado a servicios, información de contacto, preguntas frecuentes, referencias o un catálogo de conocimientos.
La diferencia con un sitio web tradicional es sencilla: un sitio web está diseñado principalmente para navegadores y usuarios. Los archivos de descubrimiento añaden una capa legible por máquinas. Esta capa permite a los agentes de IA comprender más rápidamente quién eres, qué ofreces, qué contenido es importante y qué reglas se aplican.
Arquitectura web de IA: robots.txt, Schema.org, Google Extended y ADF
En las conversaciones con los clientes, a menudo observo que se agrupan varios archivos técnicos. Es precisamente ahí donde surgen las expectativas erróneas. Por lo tanto, una clara diferenciación es fundamental.
- robots.txt: El archivo robots.txt forma parte del Protocolo de Exclusión de Robots. El RFC 9309 describe cómo los servicios pueden almacenar reglas en un archivo llamado robots.txt.
/robots.txtProporcionar información que los rastreadores deben tener en cuenta al acceder a rutas URI. - esquema.org: Datos estructurados Schema.org describe el contenido de forma semánticamente legible por máquina, por ejemplo, empresas, personas, productos, servicios, artículos o preguntas frecuentes. Schema.org se define a sí mismo como una actividad comunitaria colaborativa para datos estructurados en la web.
- Google extendido: Según Google, Google Extended es un token de producto independiente para robots.txt. Los operadores de sitios web pueden usarlo para controlar ciertos usos de Gemini Apps, Vertex AI API para Gemini y Grounding sin bloquear automáticamente la Búsqueda de Google por completo.
- llms.txt: llms.txt puede proporcionar una visión general priorizada y compatible con LLM de contenido importante. Sin embargo, llms.txt es actualmente una propuesta o una convención abierta.
- ADF: Los archivos de descubrimiento de agentes de Berger+Team combinan identidad, marca, preguntas frecuentes, derechos, catálogo de conocimientos y puntos finales de API en un patrón arquitectónico para agentes de IA.
robots.txt proporciona instrucciones para el rastreador. Schema.org describe entidades y contenido. Google Extended se refiere a usos específicos de la IA de Google. llms.txt organiza el contenido para contextos LLM. Los archivos de descubrimiento de agentes agrupan la identidad empresarial y el acceso de los agentes.
Lo que los archivos de Discovery no deben prometer
No soy partidario de presionar a las pymes para que adopten nuevas tecnologías con promesas poco realistas. Un archivo llms.txt o un conjunto ADF no pueden convertir automáticamente tu sitio web en respuestas generadas por IA. Los archivos de descubrimiento tampoco evitan las alucinaciones. Los archivos de descubrimiento no reemplazan la experiencia sustancial, un posicionamiento claro ni la calidad técnica.
Según Google Search Central, las funciones AI Overviews y AI Mode pueden mostrar enlaces relevantes en la Búsqueda de Google, pero Google no especifica ningún requisito adicional para participar, más allá de las buenas prácticas básicas de búsqueda. Por lo tanto, los archivos de descubrimiento técnico pueden ser útiles, pero no garantizan que se citen sitios web individuales.
Lo que pueden hacer los archivos de descubrimiento es más concreto y, sin embargo, igualmente valioso:
- Orientación: El contenido importante se nombra explícitamente en lugar de quedar oculto entre el ruido de la página.
- Consistencia: Los datos de la empresa, los servicios y los términos de la marca se almacenan en una ubicación legible por máquina.
- Gobernanza: Los derechos, los métodos de contacto y las normas relativas a las actualizaciones están documentados.
- Reutilización: Los mismos datos pueden alimentar el sitio web, la aplicación, la tienda, los agentes de IA y los sistemas internos.
- Menos caos de datos: Los equipos trabajan ahora con una fuente de información más clara, en lugar de con archivos PDF dispersos, textos antiguos e información contradictoria.
El enfoque arquitectónico de Berger+Team: ADF como identidad legible por máquina.
En Berger+Team, en Bolzano, no concebimos la web, la marca, el marketing y la IA por separado. Para mí, una web no es un folleto digital. Una buena web es un sistema operativo estructurado para el conocimiento de la empresa.
ADF se basa precisamente en esto. Su enfoque no parte de la tecnología, sino de la identidad: ¿Quién eres? ¿Para quién trabajas? ¿Qué problemas resuelves? ¿Qué servicios ofreces? ¿Qué se puede decir de tu marca? ¿Qué afirmaciones serían falsas o engañosas?
Si estas preguntas quedan sin respuesta, ni siquiera el mejor archivo servirá. La IA revelará rápidamente que la base es deficiente. Por eso, casi siempre combinamos los archivos de descubrimiento de agentes con la identidad de marca, la arquitectura de la información y la implementación técnica. Si desea construir esta base correctamente, nuestra estrategia web y el desarrollo web le brindan el marco práctico necesario.
Un mínimo razonable de ADF para las PYME
Una empresa gestionada por su propietario no necesita de inmediato una plataforma de agentes compleja. Para muchas pymes, una solución básica y simplificada es suficiente para empezar.
- llms.txt: Resumen seleccionado de los contenidos, servicios, guías y puntos de contacto más importantes.
- identidad.json: Identidad legible por máquina que incluye nombre, ubicación, región, idioma, sector industrial e información de contacto.
- marca.txt: Posicionamiento, tono, valores y exclusiones claras.
- faq-ai.txt: Preguntas y respuestas clave en un lenguaje preciso y fácil de citar.
- ai.txt: Información sobre derechos de contenido, citas, uso y contacto para cuestiones de licencias.
Los puntos finales de la API y un catálogo de conocimientos ampliado solo cobran especial relevancia cuando una empresa cuenta con múltiples sistemas, gran cantidad de contenido, varios idiomas o procesos automatizados.
Revisión rápida para PYMES: ¿Está preparado para llms.txt y ADF?
Antes de crear cualquier archivo, compruebe su base. Esta rápida comprobación evita trabajo técnico innecesario sin beneficio estratégico:
- Estructura de la página: ¿Existen páginas dedicadas a los servicios, los grupos objetivo, las preguntas frecuentes, la sección "Sobre nosotros" y la información de contacto?
- rendimiento: ¿Sus ofertas están claramente identificadas y formuladas de la misma manera en todas las páginas?
- Datos NAP: ¿El nombre, la dirección y el número de teléfono son consistentes, especialmente en el caso de los negocios locales en el Tirol del Sur?
- PREGUNTAS MÁS FRECUENTES: ¿Tu sitio web responde a las preguntas reales que los clientes potenciales se hacen antes de realizar una consulta?
- esquema.org: ¿Su sitio web utiliza datos estructurados para la organización, negocios locales, artículos, servicios o preguntas frecuentes?
- Derechos de contenido: ¿Está claro qué contenido debe citarse, adoptarse o no utilizarse con fines de inteligencia artificial?
- actualidad: ¿Se han actualizado los servicios, precios, datos del equipo y métodos de contacto antiguos?
- Enlace interno: ¿Están las páginas de servicio, las guías, las preguntas frecuentes y la información de contacto vinculadas lógicamente?
- Mejor prachigkeit: ¿Están el alemán, el italiano y, en su caso, el inglés, claramente separados y no mezclados?
- Puntos de contacto: ¿Existen transiciones claras entre la información y la consulta, el teléfono, el correo electrónico o el formulario?
Si tienes dudas sobre más de tres puntos, te recomiendo que primero aclares la arquitectura del sitio web. Un buen punto de partida es nuestro artículo sobre sitios web preparados para IA como base para pymes , ya que explica la lógica básica de btlabs Core.
Archivos de descubrimiento de agentes en la práctica: Cómo implementamos ADF en berger.team
Nuestra configuración en berger.team no es un modelo universalmente aplicable. Es un ejemplo de implementación de nuestro trabajo. La usamos para probar cómo interactúan el contenido del sitio web, la identidad de marca, los archivos de descubrimiento y los puntos finales de la API.
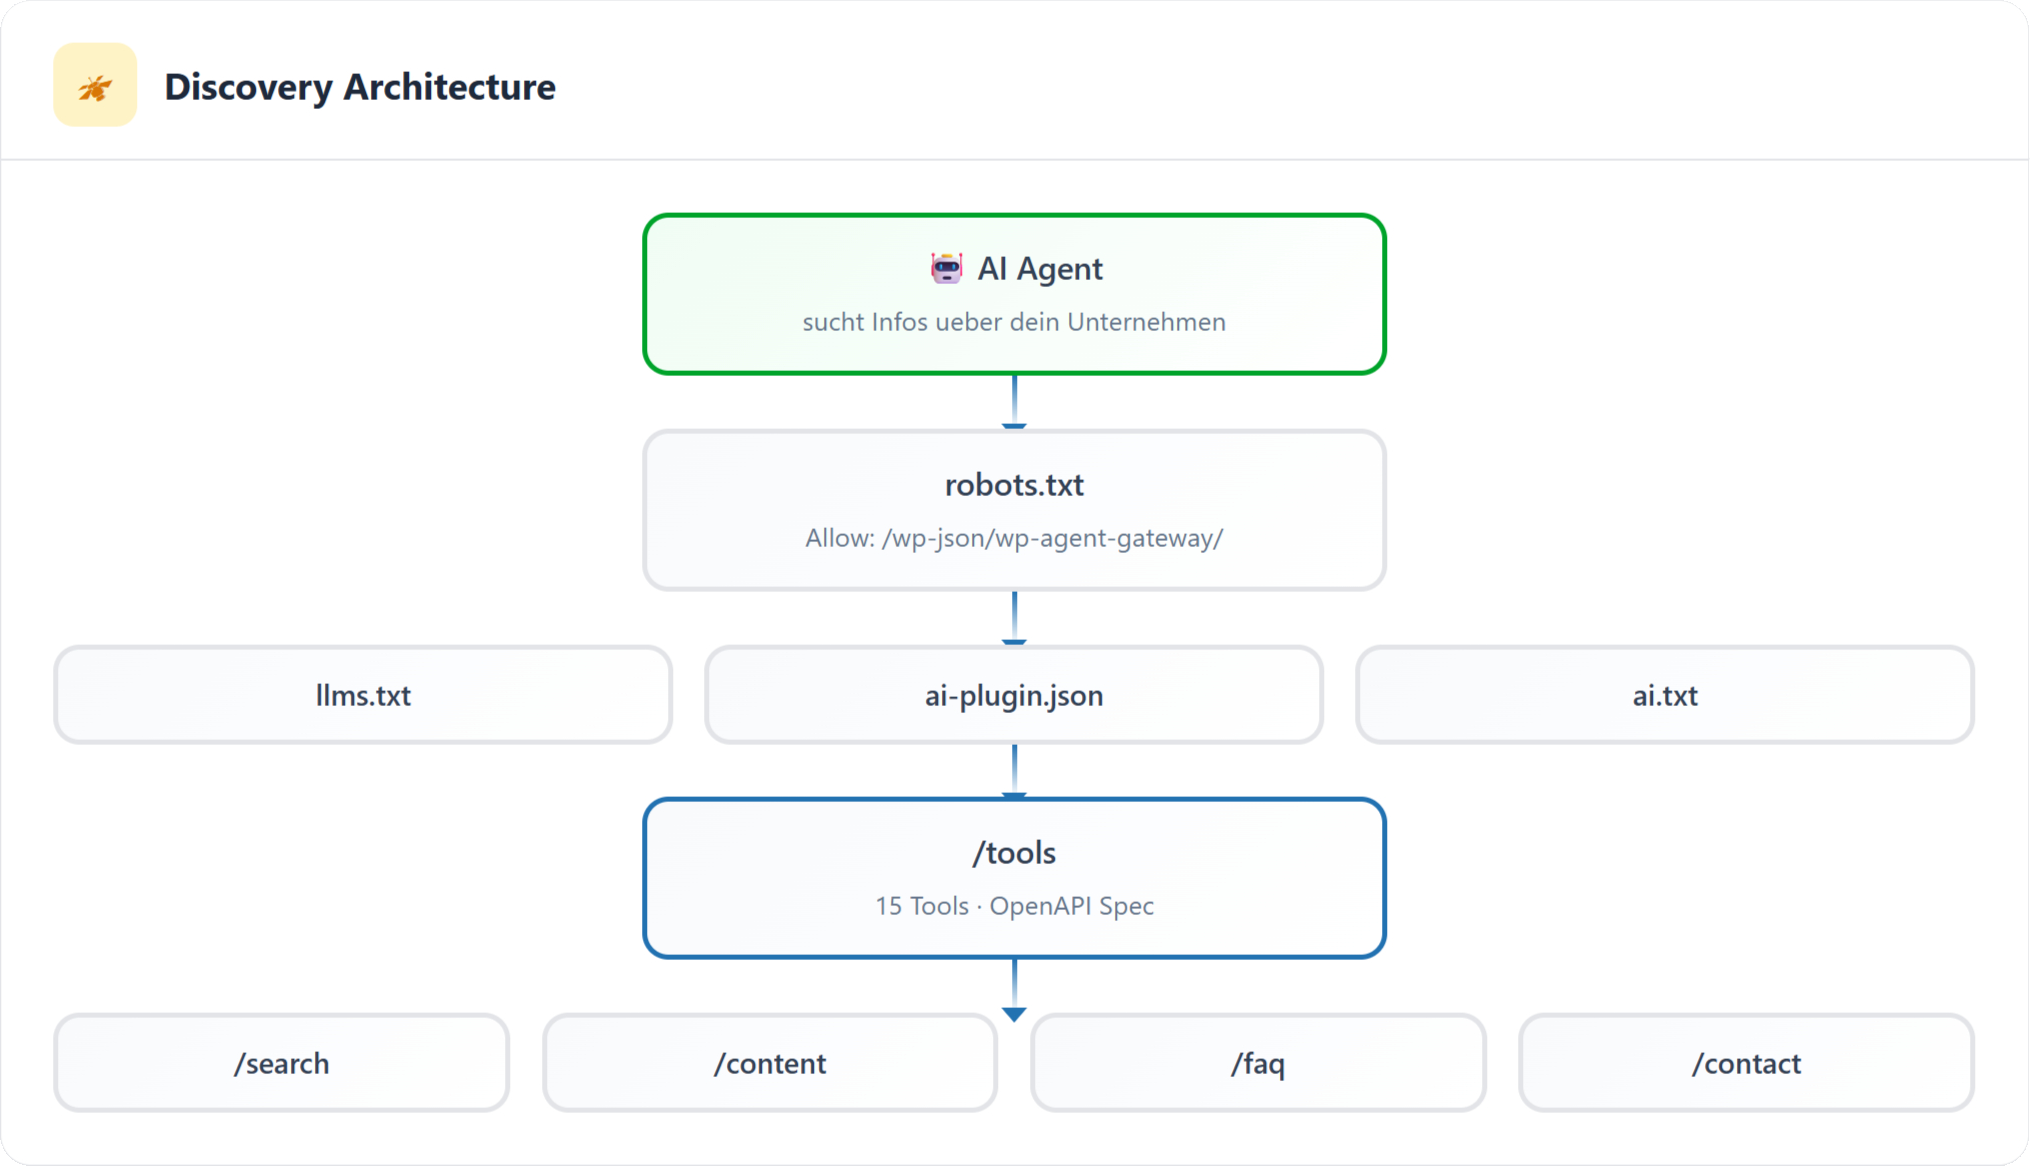
La base consiste en archivos como /llms.txt, /llms-full.txt, /robots.txt, /robots-ai.txt, /ai.txt, /ai.json, /.well-known/ai-plugin.json, /brand.txt, /faq-ai.txt, /developer-ai.txt y la /.well-known/security.txtAdemás, se proporcionan interfaces estructuradas a través de una puerta de enlace de agente. Estos puntos finales de API permiten acceder a información seleccionada, como el perfil de la empresa, los servicios, las preguntas frecuentes, los datos de contacto, la funcionalidad de búsqueda y el contenido, en un formato legible por máquina.
La clave no es el número de archivos. La clave es la distribución de roles:
- llms.txt: Proporciona orientación sobre el contenido y señala las áreas importantes.
- Expedientes de identidad: Explica quiénes somos en Berger+Team, dónde trabajamos y qué servicios ofrecemos.
- Archivos de marca: Describa el tono, la actitud y el posicionamiento.
- Archivos de preguntas frecuentes: Proporcionar respuestas breves y verificables a preguntas recurrentes.
- Puntos finales de la API: Permitir el acceso programático a datos estructurados.
- Catálogo de conocimientos: Reúne el conocimiento de tal manera que el contenido no solo se publica, sino que también se encuentra de forma sistemática.
Esta lógica resulta especialmente valiosa para las pymes cuando múltiples canales requieren la misma información: sitio web, páginas de destino, tienda online, herramientas internas, boletines informativos, procesos de venta o futuros asistentes de IA. Precisamente por eso desarrollamos btlabs Core: como una plataforma digital que estructura y reutiliza el conocimiento de la empresa.
Qué debes hacer de inmediato, qué viene después y qué es innecesario.
Utilidad inmediata
- Revisión de la arquitectura de la información: Cada página importante necesita un tema claro y un propósito claro.
- Páginas de rendimiento optimizadas: Describe específicamente a quién va dirigido el servicio, qué problema resuelve y cómo es el proceso.
- Agregar a las preguntas frecuentes: Unas buenas preguntas frecuentes ayudan a las personas, a los motores de búsqueda y a los sistemas de IA simultáneamente.
- Prioriza Schema.org: Empiece por la organización, los negocios locales, los artículos, las preguntas frecuentes y los servicios.
- Prepare llms.txt: Incluya únicamente contenido relevante, actual y estratégicamente importante.
Más adelante útil
- Ampliación de archivos ADF: Agregar reglas de marcas registradas, avisos de derechos, roles, idiomas y lógica de actualización.
- Puntos finales de la API de planificación: Utilice las interfaces únicamente para los datos que realmente deban ser legibles por máquina.
- Configurar el monitoreo: Compruebe los registros del servidor, la indexación, los errores, las URL antiguas y la antigüedad de los archivos de descubrimiento.
- Sistematizar el multilingüismo: Especialmente en el Tirol del Sur, es fundamental mantener en buen estado el alemán y el italiano.
No es necesario
- Incluya cada subpágina en llms.txt: Una selección cuidada es mejor que una colección extensa y confusa.
- Crear puntos finales de API sin un propósito: Las interfaces requieren mantenimiento. La falta de lógica de negocio genera una carga técnica.
- Ver archivos de descubrimiento como reemplazo del SEO: Sin un buen contenido y una estructura web clara, el impacto sigue siendo limitado.
- ¿Quieres forzar la visibilidad de la IA? La visibilidad surge de la sustancia, la estructura, la evidencia y la reconocibilidad.
Plan de 90 días para pymes
Si desea abordar los archivos llms.txt, los archivos de descubrimiento de agentes y los archivos de visibilidad de IA de forma estructurada, trabaje por etapas. Esto facilitará la gestión del proyecto.
Días 1 a 30: Fundamentos y claridad
- Auditoría del sitio web: Comprueba la estructura de la página, los tiempos de carga, la visualización en dispositivos móviles, la indexabilidad y los enlaces internos.
- Aclarar la identidad: Defina el nombre de la empresa, su ubicación, los servicios que ofrece, los grupos objetivo, el idioma, los valores y las exclusiones.
- Priorizar las páginas principales: Determina qué páginas son cruciales para las consultas, la confianza y la experiencia.
- Preguntas frecuentes sobre la colección: Anota las preguntas reales que surjan de las consultas, ventas, soporte y correos electrónicos.
- Estandarización de términos: Utilice los mismos términos para servicios, industrias y problemas en todas partes.
Días 31 a 60: Datos estructurados y archivos de descubrimiento
- Implementación de Schema.org: Empiece por las entidades más importantes y compruebe su validez técnica.
- Crear llms.txt: Selecciona contenido importante, explica el sitio web y enlaza a las secciones clave.
- Crear una base ADF: Crear un archivo de identidad,
brand.txt,faq-ai.txty un simple archivo de derechos. - Limpiar el contenido: Elimine las declaraciones obsoletas, los nombres de productos contradictorios y los enlaces rotos.
- Comprobar el multilingüismo: Asegúrese de que el contenido en alemán e italiano coincida correctamente.
Días 61 a 90: API, puerta de enlace de agente y monitorización.
- Seleccione los puntos finales de la API: Comience con los servicios, las preguntas frecuentes, la información de contacto y el perfil de la empresa.
- Estructuración del catálogo de conocimientos: Determina qué contenido es canónico y cuál es meramente complementario.
- Definir gobernanza: Aclarar quién se encarga del mantenimiento de los archivos, cuándo se realizan las actualizaciones y qué permisos se necesitan.
- Configurar el sistema de monitorización: Comprueba si hay errores, si el rastreo web está activo, si los registros del servidor están actualizados y si los archivos están al día.
- Iterar: Adapta el contenido en función de las consultas reales, los datos de búsqueda y el comportamiento del usuario.
Si necesita ayuda con esto, nuestros servicios de consultoría en IA y digitalización están diseñados deliberadamente para ser prácticos: primero la estrategia, luego la arquitectura y, finalmente, la implementación.
Por qué los archivos de descubrimiento de agentes son relevantes para las pequeñas empresas
Me gusta trabajar con empresas familiares, expertos y equipos pequeños porque las decisiones se toman de forma más directa. Al mismo tiempo, los recursos son más limitados. Por lo tanto, la visibilidad digital no debe consistir en medidas aisladas y aleatorias.
Una empresa en Bolzano, Merano, Bressanone o el resto del Tirol del Sur no necesita comunicarse más que las grandes compañías. Simplemente necesita comunicarse con mayor claridad. Un posicionamiento claro, páginas de servicios bien organizadas, preguntas frecuentes relevantes, datos consistentes y una identidad legible por máquina pueden ayudar a las pequeñas empresas a ser mejor comprendidas digitalmente.
Para mí, también es una cuestión de actitud. La tecnología debería empoderar a las pequeñas empresas, no solo hacer que las grandes crezcan aún más. Se crea una situación beneficiosa para todos cuando las personas pueden tomar mejores decisiones, las empresas se vuelven más sostenibles y visibles, y los sistemas técnicos generan menos caos.
Si desea ampliar sus conocimientos sobre el tema, encontrará la base adecuada para la visibilidad en sistemas generativos en nuestro artículo sobre GEO, SEO, AEO y AAO .
Preguntas frecuentes sobre llms.txt, ADF y archivos de descubrimiento de KI
¿Es llms.txt un estándar oficial?
No. Actualmente, llms.txt es una convención o propuesta abierta, y no un estándar oficial como los estándares ratificados del W3C o la IETF. Aún puedes usar llms.txt, pero debes entenderlo como una guía y no como un mecanismo de control garantizado.
¿Garantiza llms.txt su visibilidad en ChatGPT o en las vistas generales de IA de Google?
No. llms.txt puede gestionar el contenido y facilitar el aprendizaje automático, pero no garantiza su inclusión ni su citación en las respuestas de la IA. Google no especifica ningún requisito adicional para las Reseñas de IA de Google más allá de las buenas prácticas básicas de búsqueda.
¿Cuál es la diferencia entre ADF y Schema.org?
Schema.org es un vocabulario consolidado para datos estructurados que permite describir el contenido semánticamente. En Berger+Team, ADF es un patrón arquitectónico que integra, además, identidad, marca, preguntas frecuentes, gestión de derechos, catálogo de conocimiento y puntos finales de API como capa de descubrimiento.
¿Cuál es la diferencia entre los archivos de descubrimiento de agentes y robots.txt?
El archivo robots.txt proporciona a los rastreadores instrucciones sobre qué rutas pueden acceder y cuáles no. Por otro lado, los archivos de descubrimiento de agentes describen en términos legibles por máquina quién es su empresa, qué contenido es importante y cómo los agentes de IA pueden acceder a la información estructurada.
¿Todas las PYMES necesitan puntos finales de API?
No. Muchas pymes deberían implementar primero correctamente la estructura del sitio web, Schema.org, llms.txt y archivos ADF sencillos. Los puntos finales de la API solo resultan útiles cuando los servicios, las preguntas frecuentes, la disponibilidad, el contenido o los procesos se van a reutilizar con regularidad en un formato legible por máquina.
¿Los archivos de visibilidad de IA son lo mismo que los archivos de descubrimiento de IA?
Aunque a menudo se utilizan términos similares, no están estrictamente estandarizados. Yo uso "Archivos de descubrimiento de IA" como término general para los archivos que proporcionan orientación a los agentes de IA, y "Archivos de visibilidad de IA" para los archivos que permiten la visibilidad, la clasificación y la presentación legible por máquina.
¿Qué archivo debo crear primero?
Empiece por hacer un inventario honesto de sus páginas más importantes. Después, un archivo llms.txt sencillo, un archivo de identidad y una sección de preguntas frecuentes bien organizada suelen ser el mejor punto de partida, ya que estos tres elementos aportan claridad rápidamente.
¿Con qué frecuencia es necesario actualizar los archivos llms.txt y los archivos de descubrimiento de agentes?
Esto es necesario siempre que cambien los servicios, las ubicaciones, las personas de contacto, las URL, el posicionamiento o el contenido importante. En la práctica, también recomiendo que las pymes realicen una revisión trimestral para garantizar que los archivos de descubrimiento no queden obsoletos.
¿Puedo implementar los archivos de descubrimiento de agentes sin un sitio web nuevo?
En parte, sí. Puedes añadir archivos de descubrimiento sencillos a un sitio web existente. Sin embargo, si el sitio web tiene contenido poco claro, páginas de rendimiento obsoletas o problemas técnicos, primero deberías mejorar su base.
¿Cuál es el mayor error con llms.txt y ADF?
El mayor error es considerar los archivos técnicos como un atajo. Si tu marca, servicios y contenido no están claros, los archivos de descubrimiento solo hacen que esa ambigüedad sea legible para las máquinas. La estrategia es primordial, antes que la apariencia y la tecnología.
pensamientos finales
Los archivos llms.txt y Agent Discovery Files son útiles cuando se usan correctamente: sirven de guía, permiten la gobernanza y complementan un sitio web robusto con información legible por máquina. llms.txt no es un estándar oficial, ADF es un enfoque arquitectónico de Berger+Team y ninguno de los dos reemplaza una estrategia.
Para las pymes, la decisión más importante no es si cada archivo nuevo es perfecto desde el principio. La decisión más importante es si su empresa está claramente descrita digitalmente: para las personas, los motores de búsqueda y los agentes de IA. Ahí es precisamente donde se crea una visibilidad sostenible para la IA.
Mi consejo: Empiece poco a poco, pero con claridad. Defina su identidad. Optimice sus páginas más importantes. Añada datos estructurados. Cree un archivo llms.txt organizado. Amplíe los archivos de descubrimiento de agentes solo donde ADF realmente ofrezca orden, reutilización y una mejor interpretabilidad para las máquinas.
Mar de fondo
- Jeremy Howard / llmstxt.org: El archivo /llms.txt — llmstxt.org (2024)
- Editor de IETF/RFC: RFC 9309, Protocolo de exclusión de robots — rfc-editor.org (2022)
- Schema.org — schema.org
- Google Search Central: Rastreadores comunes — developers.google.com (2025)
- Google Search Central: Funciones de IA y tu sitio web — developers.google.com (2025)
- Núcleo de btlabs

