

I file di rilevamento degli agenti (Agent Discovery Files) e il file llms.txt descrivono una configurazione pratica dei file di rilevamento dell'IA: llms.txt può fornire modelli linguistici con indicazioni sui contenuti importanti del sito web, mentre ADF, come approccio architetturale di Berger+Team, raggruppa informazioni leggibili dalle macchine su identità, branding, FAQ, copyright, catalogo della conoscenza ed endpoint API.
È importante comprendere il contesto: llms.txt è attualmente una convenzione o una proposta, non uno standard ufficiale come uno standard ratificato dal W3C o dall'IETF. Questo file non sostituisce la SEO, i dati strutturati sul tuo sito web o una chiara architettura delle informazioni. Secondo la pagina di proposta di llms.txt di Jeremy Howard, si tratta di un file Markdown suggerito che fornisce informazioni compatibili con LLM. Puoi trovare il codice sorgente alla fine di questo articolo.
I file di discovery non costituiscono un meccanismo di controllo per le risposte dell'IA. Possono fornire indicazioni, migliorare l'interpretabilità delle macchine e rendere trasparente la governance. Tuttavia, i file di discovery non garantiscono la citazione in ChatGPT, nelle panoramiche sull'IA di Google o in altre risposte dell'IA.
Scrivo questa guida basandomi sulla mia esperienza pratica con le PMI di Bolzano, in Alto Adige e nella regione DACH (Germania, Austria, Svizzera). In oltre 20 anni di esperienza nel branding, nello sviluppo web e nella strategia digitale, ho imparato che le piccole imprese non hanno bisogno di ulteriore complessità tecnica. Hanno bisogno di un sistema semplice e intuitivo che spieghi chiaramente il loro marchio, i servizi offerti, le sedi, le modalità di contatto e i diritti – per le persone, i motori di ricerca e, sempre più spesso, gli agenti basati sull'intelligenza artificiale.
File di rilevamento dell'agente e llms.txt: a cosa servono i file di rilevamento
llms.txt è un file di testo nella directory principale di un sito web, solitamente sotto /llms.txtIl file può organizzare pagine importanti, documentazione, aree di servizio o FAQ in modo tale che i modelli linguistici e gli strumenti possano accedere più rapidamente alla struttura del sito web. L'obiettivo è l'orientamento, non il controllo.
Per noi, gli Agent Discovery File , o ADF in breve , non rappresentano uno standard di settore generalmente accettato. ADF è un approccio architetturale di Berger+Team : un insieme di file e interfacce leggibili dalle macchine che conferisce a un sito web un'identità più chiara e facilmente comprensibile. Io utilizzo ADF come modello architetturale, non come standard.
Una configurazione ADF può, ad esempio, contenere i seguenti componenti:
- File di identità: Nome dell'azienda, sede, forma giuridica, persona di contatto, lingue, regione e aree di servizio.
- File del marchio: Posizionamento, tono di voce, valori, gruppi target, esclusioni e regole di comunicazione.
- File FAQ: Domande frequenti con risposte chiare e coerenti con il contenuto del sito web.
- File relativi a diritti e utilizzo: Istruzioni su come il contenuto deve essere utilizzato, citato o non utilizzato.
- Endpoint API: Accesso strutturato a servizi, informazioni di contatto, domande frequenti (FAQ), riferimenti o un catalogo di conoscenze.
La differenza rispetto a un sito web tradizionale è semplice: un sito web è progettato principalmente per i browser e per gli esseri umani. I file di discovery aggiungono un livello leggibile dalle macchine al sito web. Questo livello può aiutare gli agenti di intelligenza artificiale a comprendere più rapidamente chi sei, cosa offri, quali contenuti sono importanti e quali regole si applicano.
Architettura Web per l'IA: robots.txt, Schema.org, Google Extended e ADF
Nelle discussioni con i clienti, noto spesso che diversi file tecnici vengono raggruppati insieme. È proprio in questi casi che nascono false aspettative. Pertanto, una chiara distinzione è fondamentale.
- robots.txt: Il file robots.txt fa parte del Robots Exclusion Protocol. La RFC 9309 descrive come i servizi possono memorizzare le regole in un file chiamato robots.txt.
/robots.txtfornire informazioni che i crawler dovrebbero considerare quando accedono ai percorsi URI. - Schema.org: Dati strutturati Schema.org descrive i contenuti in un formato semanticamente leggibile dalle macchine, ad esempio aziende, persone, prodotti, servizi, articoli o FAQ. Schema.org si definisce un'attività collaborativa di una comunità per i dati strutturati sul web.
- Google-Extended: Secondo Google, Google Extended è un token di prodotto autonomo per robots.txt. Gli operatori di siti web possono utilizzarlo per controllare determinati utilizzi da parte di Gemini Apps, Vertex AI API per Gemini e Grounding, senza bloccare automaticamente e completamente la Ricerca Google.
- llms.txt: Il file llms.txt può fornire una panoramica prioritaria e adatta ai modelli LLM dei contenuti importanti. Tuttavia, llms.txt è attualmente una proposta o una convenzione aperta.
- ADF: I file di rilevamento degli agenti di Berger+Team combinano identità, marchio, FAQ, diritti, catalogo di conoscenze ed endpoint API in un modello architetturale per agenti di intelligenza artificiale.
Il file robots.txt fornisce istruzioni per i crawler. Schema.org descrive entità e contenuti. Google Extended si riferisce a specifici utilizzi dell'IA di Google. Il file llms.txt organizza i contenuti per i contesti LLM. I file di rilevamento degli agenti raggruppano l'identità aziendale e l'accesso degli agenti.
Cosa non devono promettere i documenti di discovery
Non sono un fan dell'idea di spingere le PMI verso nuove tecnologie con promesse irrealistiche. Un file llms.txt o un set ADF non possono trasformare automaticamente il vostro sito web in risposte generate dall'intelligenza artificiale. Nemmeno i file di discovery impediscono di farsi illusioni. I file di discovery non sostituiscono la competenza specifica, un posizionamento chiaro o la qualità tecnica.
Secondo Google Search Central, per la Ricerca Google, le Panoramiche AI e la Modalità AI possono visualizzare link pertinenti, ma Google non specifica requisiti aggiuntivi per la partecipazione oltre alle best practice di base per la ricerca. Pertanto, i file di rilevamento tecnici possono essere utili, ma non possono garantire che i singoli siti web vengano citati.
Ciò che i file di discovery possono fare è più concreto e comunque prezioso:
- Orientamento: I contenuti importanti vengono indicati esplicitamente anziché essere nascosti tra gli elementi superflui della pagina.
- Consistenza: I dati aziendali, i servizi e i termini del marchio sono memorizzati in una posizione leggibile da una macchina.
- Governance: I diritti, le modalità di contatto e le norme relative agli aggiornamenti sono documentati.
- Riutilizzabilità: Gli stessi dati possono essere forniti al sito web, all'app, al negozio, agli agenti di intelligenza artificiale e ai sistemi interni.
- Meno caos nei dati: I team lavorano con una fonte di informazioni più chiara e affidabile, anziché con PDF sparsi, testi obsoleti e informazioni contraddittorie.
L'approccio architettonico di Berger+Team: ADF come identità leggibile dalla macchina.
Noi di Berger+Team a Bolzano non consideriamo siti web, branding, marketing e intelligenza artificiale come elementi separati. Per me, un sito web non è una brochure digitale. Un buon sito web è un sistema operativo strutturato per la conoscenza aziendale.
ADF si basa proprio su questo. L'approccio non parte dalla tecnologia, ma dall'identità: Chi sei? Per chi lavori? Quali problemi risolvi? Quali servizi offri? Cosa si può dire del tuo marchio? Quali affermazioni sarebbero false o fuorvianti?
Se queste domande rimangono senza risposta, nemmeno il miglior file sarà d'aiuto. L'intelligenza artificiale rivelerà rapidamente che le fondamenta sono incomplete. Ecco perché integriamo quasi sempre i file di analisi degli agenti con il branding, l'architettura dell'informazione e l'implementazione tecnica. Se desiderate costruire queste fondamenta in modo corretto, la nostra strategia per siti web e lo sviluppo web vi forniranno il quadro pratico necessario.
Un minimo di ADF ragionevole per le PMI
Un'azienda a conduzione familiare non ha bisogno immediatamente di una piattaforma di agenti complessa. Per molte PMI, una soluzione minimale e semplificata è sufficiente per iniziare.
- llms.txt: Una selezione accurata dei contenuti, servizi, guide e contatti più importanti.
- identity.json: Dati identificativi leggibili da una macchina, inclusi nome, luogo di residenza, regione, lingua, settore di attività e informazioni di contatto.
- brand.txt: Posizionamento, tono, valori ed esclusioni chiare.
- faq-ai.txt: Domande e risposte chiave in un linguaggio preciso e facilmente citabile.
- ai.txt: Informazioni sui diritti d'autore, le modalità di citazione, l'utilizzo e i contatti per domande relative alle licenze.
Gli endpoint API e un catalogo di conoscenze ampliato diventano particolarmente rilevanti solo quando un'azienda possiede più sistemi, una grande quantità di contenuti, più lingue o processi automatizzati.
Verifica rapida per le PMI: siete pronti per llms.txt e ADF?
Prima di creare qualsiasi file, verifica le tue basi. Questo rapido controllo evita inutili lavori tecnici senza alcun vantaggio strategico:
- Struttura della pagina: Sono presenti pagine dedicate ai servizi, ai gruppi target, alle domande frequenti, alla sezione "Chi siamo" e ai contatti?
- performance: Le tue offerte sono chiaramente denominate e formulate allo stesso modo su tutte le pagine?
- Dati NAP: Il nome, l'indirizzo e il numero di telefono sono coerenti, soprattutto per le attività commerciali locali in Alto Adige?
- FAQ: Il tuo sito web risponde alle domande concrete che i potenziali clienti si pongono prima di inviare una richiesta di informazioni?
- Schema.org: Il tuo sito web utilizza dati strutturati per l'organizzazione, le attività commerciali locali, gli articoli, i servizi o le FAQ?
- Diritti sui contenuti: È chiaro quali contenuti debbano essere citati, adottati o non utilizzati per scopi di intelligenza artificiale?
- attualità: Sono stati eliminati i vecchi servizi, prezzi, dati del team e metodi di contatto?
- Collegamento interno: Le pagine dei servizi, le guide, le FAQ e le informazioni di contatto sono collegate in modo logico?
- Multilinguismo: Il tedesco, l'italiano e, se applicabile, l'inglese sono chiaramente separati e non mescolati?
- Punti di contatto: Esistono passaggi chiari tra le informazioni e le richieste di informazioni, le comunicazioni telefoniche, via e-mail o tramite modulo?
Se hai dubbi su più di tre punti, ti consiglio innanzitutto di chiarire l'architettura del sito web. Un buon punto di partenza è il nostro articolo sui siti web predisposti per l'intelligenza artificiale come base per le PMI , perché spiega la logica di base di btlabs Core.
File di individuazione degli agenti (Agent Discovery Files - ADF) nella pratica: come implementiamo ADF in berger.team
La nostra configurazione su berger.team non è un modello universalmente applicabile. Si tratta di un esempio di implementazione tratto dal nostro lavoro. La utilizziamo per testare come interagiscono i contenuti del sito web, l'identità del marchio, i file di discovery e gli endpoint API.
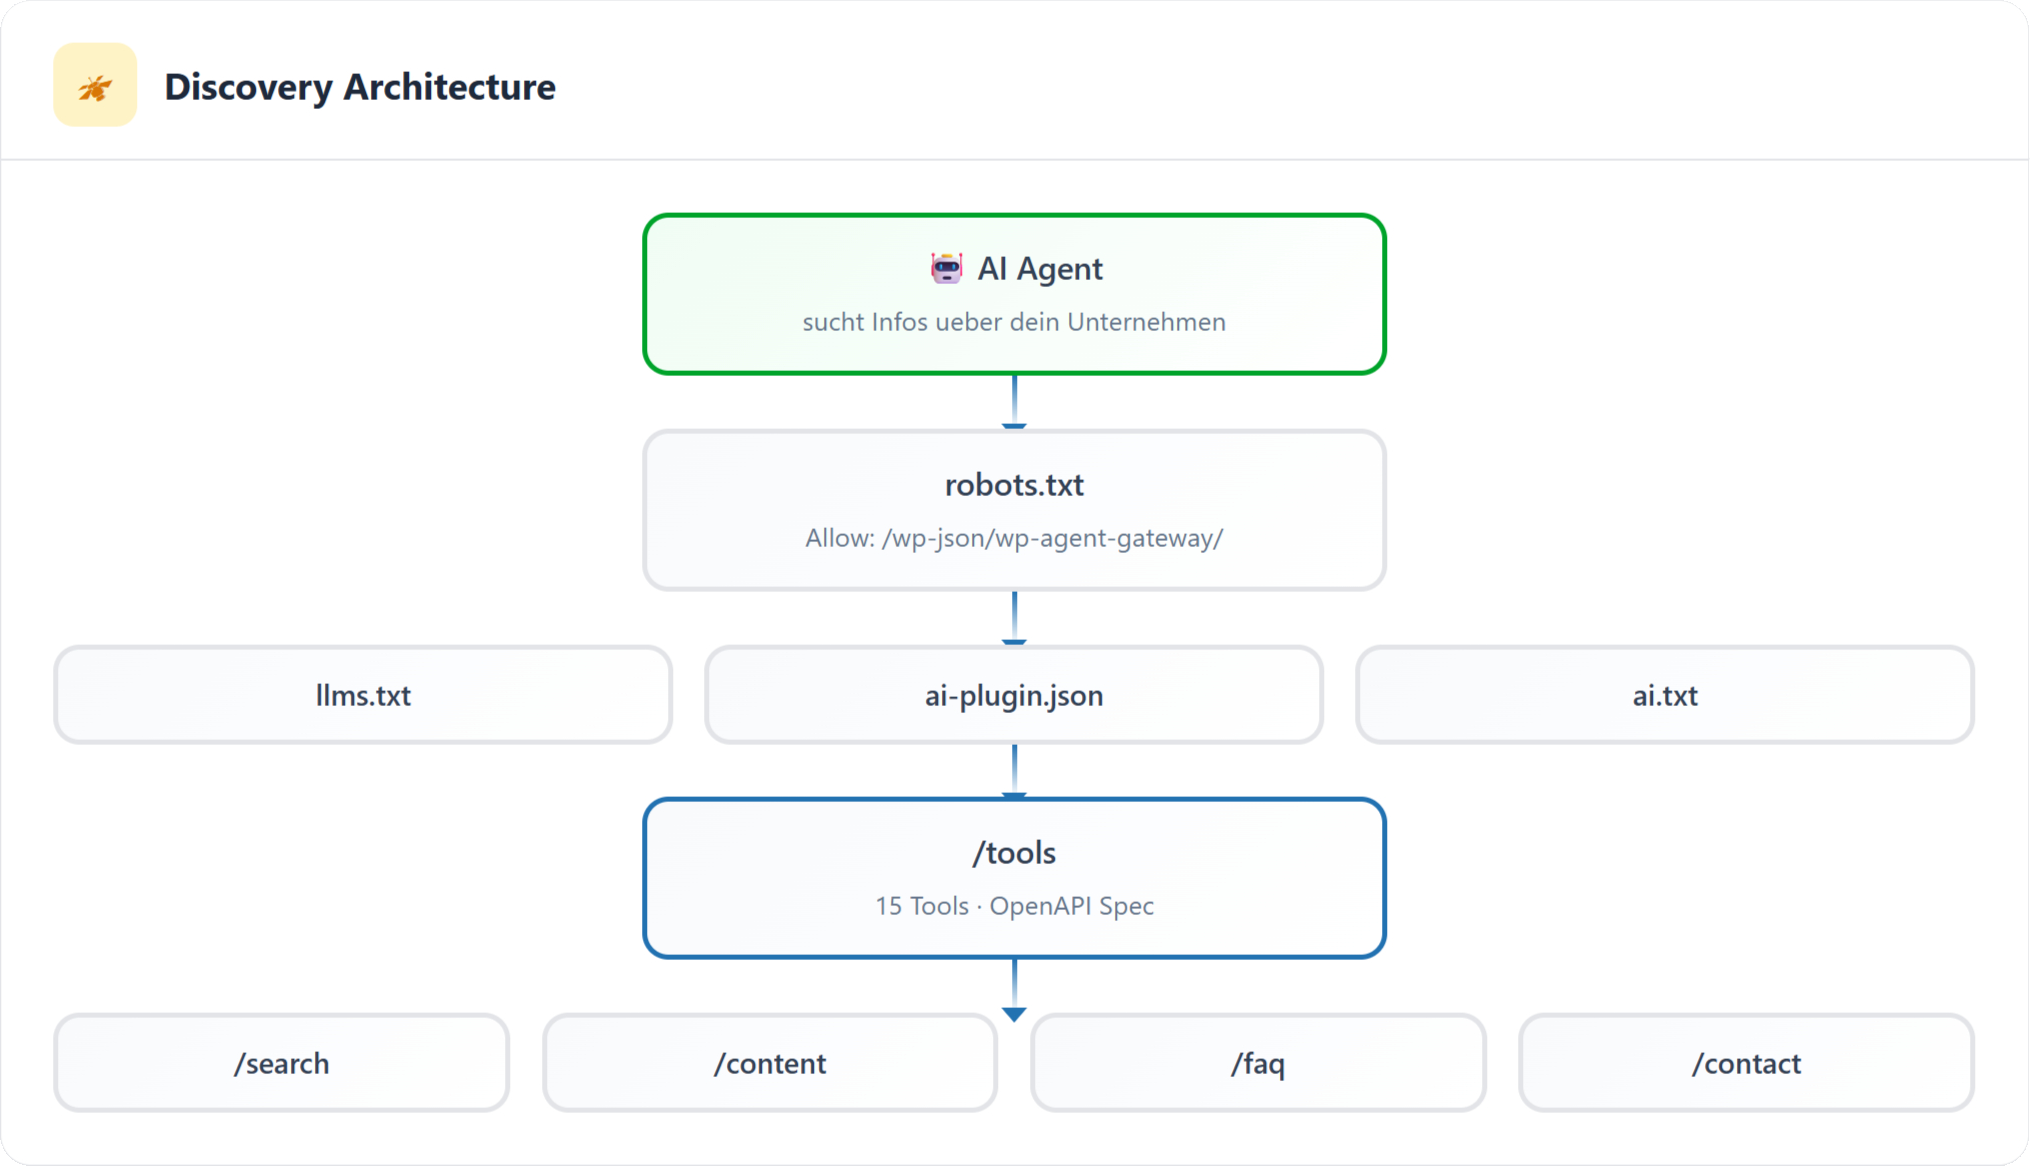
La base è costituita da file come /llms.txt, /llms-full.txt, /robots.txt, /robots-ai.txt, /ai.txt, /ai.json, /.well-known/ai-plugin.json, /brand.txt, /faq-ai.txt, /developer-ai.txt e /.well-known/security.txtInoltre, tramite un gateway agente vengono fornite interfacce strutturate. Questi endpoint API rendono disponibili informazioni selezionate, come profilo aziendale, servizi, FAQ, recapiti, funzionalità di ricerca e contenuti, in un formato leggibile dalle macchine.
La chiave non sta nel numero di file. La chiave sta nella distribuzione dei ruoli:
- llms.txt: Fornisce indicazioni sui contenuti e segnala le aree importanti.
- File di identità: Spiegate chi è Berger+Team, dove operiamo e quali servizi offriamo.
- File del marchio: Descrivi il tono, l'atteggiamento e il posizionamento.
- File FAQ: Fornire risposte brevi e verificabili a domande ricorrenti.
- Endpoint API: consentire l'accesso programmatico ai dati strutturati.
- Catalogo della conoscenza: Raccoglie le conoscenze in modo tale che i contenuti non solo vengano pubblicati, ma anche reperiti in modo sistematico.
Questa logica è particolarmente preziosa per le PMI quando più canali richiedono le stesse informazioni: sito web, landing page, negozio online, strumenti interni, newsletter, processi di vendita o futuri assistenti virtuali basati sull'intelligenza artificiale. È proprio per questo che abbiamo sviluppato btlabs Core: una piattaforma digitale che struttura e riutilizza il know-how aziendale.
Cosa fare subito, cosa fare dopo e cosa è superfluo.
Immediatamente utile
- Revisione dell'architettura delle informazioni: Ogni pagina importante necessita di un tema chiaro e di uno scopo ben definito.
- Ottimizza le pagine relative alle prestazioni: Descrivi in modo specifico a chi è destinato il servizio, quale problema risolve e come si svolge il processo.
- Aggiungi alle FAQ: Delle buone FAQ aiutano contemporaneamente le persone, i motori di ricerca e i sistemi di intelligenza artificiale.
- Dai priorità a Schema.org: Iniziate con l'organizzazione, le attività commerciali locali, gli articoli, le domande frequenti e i servizi.
- Prepara il file llms.txt: Includi solo contenuti pertinenti, attuali e strategicamente importanti.
Utile in seguito
- Estensione dei file ADF: Aggiungi le regole relative ai marchi, le note sui diritti, i ruoli, le lingue e la logica di aggiornamento.
- Pianificazione degli endpoint API: Utilizzate le interfacce solo per i dati che devono essere effettivamente leggibili dalle macchine.
- Configura il monitoraggio: Controlla i log del server, l'indicizzazione, gli errori, gli URL obsoleti e la data di creazione dei file di rilevamento.
- Sistematizzare il multilinguismo: Soprattutto in Alto Adige, è fondamentale mantenere un buon livello di conoscenza del tedesco e dell'italiano.
Non necessario
- Includi ogni sottopagina nel file llms.txt: Una selezione accurata è preferibile a una raccolta confusa e onnicomprensiva.
- Creare endpoint API senza uno scopo preciso: Le interfacce richiedono manutenzione. La mancanza di logica aziendale crea un onere tecnico.
- Visualizza i file di discovery come alternativa alla SEO: Senza contenuti di qualità e una struttura chiara del sito web, l'impatto rimane limitato.
- Vuoi forzare la visibilità dell'IA? La visibilità deriva da sostanza, struttura, prove e riconoscibilità.
Piano di lavoro di 90 giorni per le PMI
Se desideri affrontare i file llms.txt, Agent Discovery Files e AI Visibility Files in modo strutturato, procedi per fasi. Questo renderà il progetto più gestibile.
Dal giorno 1 al giorno 30: Fondamenti e chiarezza
- Audit del sito web: Verifica la struttura della pagina, i tempi di caricamento, la visualizzazione su dispositivi mobili, l'indicizzazione e i link interni.
- Chiarire l'identità: Definisci il nome dell'azienda, la sede, i servizi, i gruppi target, la lingua, i valori e le esclusioni.
- Dai priorità alle pagine principali: Determina quali pagine sono cruciali per le richieste di informazioni, la fiducia e la competenza.
- Raccogli le domande frequenti: Annota le domande reali che emergono durante le consulenze, le vendite, l'assistenza e le richieste via e-mail.
- Termini di standardizzazione: Utilizzate la stessa terminologia per servizi, settori e problemi ovunque.
Dal giorno 31 al giorno 60: Dati strutturati e file di scoperta
- Implementazione di Schema.org: Iniziate con le entità più importanti e verificatene la validità tecnica.
- Crea il file llms.txt: Seleziona i contenuti più importanti, spiega il sito web e inserisci i link alle sezioni principali.
- Creare una base ADF: Crea un file di identità,
brand.txt,faq-ai.txte un semplice file dei diritti. - Pulizia dei contenuti: Rimuovi le dichiarazioni obsolete, i nomi dei prodotti contraddittori e i link non funzionanti.
- Verifica il multilinguismo: Correttamente la traduzione dei contenuti in tedesco e in italiano.
Giorni dal 61 al 90: API, Agent Gateway e monitoraggio
- Seleziona gli endpoint API: Inizia con i servizi offerti, le domande frequenti (FAQ), le informazioni di contatto e il profilo aziendale.
- Strutturare il catalogo della conoscenza: Determinare quali contenuti sono canonici e quali sono meramente supplementari.
- Definisci la governance: Chiarire chi gestisce i file, quando vengono aggiornati e quali autorizzazioni sono necessarie.
- Configurazione del monitoraggio: Verifica la presenza di errori, lo stato di scansione, i log del server e l'aggiornamento dei file.
- Ripeti: Adatta i contenuti in base a query reali, dati di ricerca e comportamento degli utenti.
Se hai bisogno di supporto in questo ambito, i nostri servizi di consulenza per l'IA e la digitalizzazione sono volutamente pensati per essere pratici: prima la strategia, poi l'architettura e infine l'implementazione.
Perché i file di rilevamento degli agenti sono rilevanti per le piccole imprese
Mi piace lavorare con aziende a conduzione familiare, esperti e piccoli team perché le decisioni vengono prese in modo più diretto. Allo stesso tempo, le risorse sono più limitate. Pertanto, la visibilità digitale non dovrebbe basarsi su misure casuali e isolate.
Un'azienda di Bolzano, Merano, Bressanone o del resto dell'Alto Adige non ha bisogno di comunicare più delle aziende più grandi. Deve semplicemente comunicare in modo più chiaro. Un posizionamento chiaro, pagine di servizi ben organizzate, FAQ pertinenti, dati coerenti e un'identità digitale leggibile dai motori di ricerca possono aiutare le piccole imprese a essere comprese meglio online.
Per me, è anche una questione di atteggiamento. La tecnologia dovrebbe potenziare le piccole imprese, non solo rendere ancora più grandi quelle grandi. Si crea una situazione vantaggiosa per tutti quando le persone possono prendere decisioni migliori, le aziende diventano più sostenibili e visibili e i sistemi tecnici generano meno caos.
Se desideri approfondire la tua comprensione dell'argomento, troverai le basi appropriate per la visibilità nei sistemi generativi nel nostro articolo su GEO, SEO, AEO e AAO .
Domande frequenti (FAQ) su llms.txt, ADF e file di rilevamento KI.
llms.txt è uno standard ufficiale?
No. llms.txt è attualmente una convenzione o proposta aperta e non uno standard ufficiale come uno standard ratificato dal W3C o dall'IETF. È comunque possibile utilizzare llms.txt, ma è importante intenderlo come una linea guida e non come un meccanismo di controllo garantito.
Il file llms.txt garantisce la visibilità in ChatGPT o nelle panoramiche di Google AI?
No. llms.txt può curare i contenuti e facilitare l'apprendimento automatico, ma non può garantire l'inclusione o la citazione nelle risposte dell'IA. Google non specifica requisiti aggiuntivi per le panoramiche sull'IA di Google oltre alle best practice di base per la ricerca.
Qual è la differenza tra ADF e Schema.org?
Schema.org è un vocabolario consolidato per i dati strutturati, che consente di descrivere semanticamente i contenuti. Per Berger+Team, ADF è un modello architetturale che integra inoltre identità, branding, FAQ, gestione dei diritti, catalogo della conoscenza ed endpoint API come livello di individuazione.
Qual è la differenza tra Agent Discovery Files e robots.txt?
Il file robots.txt fornisce ai crawler istruzioni sui percorsi a cui possono accedere e su quelli a cui non dovrebbero. I file di rilevamento degli agenti, invece, descrivono in termini leggibili dalle macchine chi è la tua azienda, quali contenuti sono importanti e come gli agenti di intelligenza artificiale possono accedere alle informazioni strutturate.
Tutte le PMI hanno bisogno di endpoint API?
No. Molte PMI dovrebbero prima implementare correttamente la struttura del sito web, Schema.org, llms.txt e semplici file ADF. Gli endpoint API diventano utili solo quando servizi, FAQ, disponibilità, contenuti o processi devono essere riutilizzati regolarmente in un formato leggibile da una macchina.
I file di visibilità dell'IA sono uguali ai file di rilevamento dell'IA?
I termini vengono spesso usati in modo simile, ma non sono rigorosamente standardizzati. Io uso "AI Discovery Files" come termine generico per i file che forniscono un orientamento agli agenti di intelligenza artificiale e "AI Visibility Files" per i file che supportano la visibilità, la classificazione e la presentazione leggibile dalle macchine.
Quale file devo creare per primo?
Iniziate con un inventario onesto delle vostre pagine più importanti. Dopodiché, un semplice file llms.txt, un file di identità e una sezione FAQ chiara sono solitamente il punto di partenza migliore, perché questi tre elementi forniscono rapidamente chiarezza.
Con quale frequenza è necessario aggiornare i file llms.txt e Agent Discovery Files?
Ciò è necessario ogni qualvolta cambiano servizi, sedi, persone di contatto, URL, posizionamento o contenuti importanti. In pratica, consiglio inoltre alle PMI di effettuare una revisione trimestrale per garantire che i file di discovery non diventino obsoleti.
Posso implementare i file di rilevamento degli agenti senza creare un nuovo sito web?
In parte, sì. È possibile aggiungere semplici file di rilevamento a un sito web esistente. Tuttavia, se il sito web presenta contenuti poco chiari, pagine relative alle prestazioni obsolete o problemi tecnici, è consigliabile prima migliorare le fondamenta.
Qual è l'errore più comune con llms.txt e ADF?
L'errore più grande è considerare i file tecnici come una scorciatoia. Se il tuo marchio, i tuoi servizi e i tuoi contenuti non sono chiari, i file di discovery non fanno altro che rendere quell'ambiguità comprensibile alle macchine. La strategia viene prima dell'apparenza e della tecnologia.
pensieri di chiusura
I file llms.txt e Agent Discovery File sono utili se usati correttamente: come guida, strumento di governance e supplemento leggibile dalle macchine a un sito web efficace. llms.txt non è uno standard ufficiale, ADF è un approccio architetturale di Berger+Team e nessuno dei due sostituisce una strategia.
Per le PMI, la decisione più importante non è se ogni nuovo file sia perfetto fin da subito. La decisione più importante è se la propria azienda sia descritta in modo chiaro in digitale: per le persone, i motori di ricerca e gli agenti di intelligenza artificiale. È proprio così che si crea una visibilità sostenibile basata sull'IA.
Il mio consiglio: iniziate in piccolo ma con cura. Definite la vostra identità. Ottimizzate le pagine più importanti. Aggiungete dati strutturati. Create un file llms.txt ben organizzato. Espandete i file di rilevamento degli agenti (Agent Discovery Files) solo laddove ADF offra effettivamente ordine, riutilizzabilità e una migliore interpretabilità automatica.
Swell
- Jeremy Howard / llmstxt.org: Il file /llms.txt — llmstxt.org (2024)
- Editor IETF/RFC: RFC 9309, Protocollo di esclusione dei robot — rfc-editor.org (2022)
- Schema.org — schema.org
- Google Search Central: Crawler comuni — developers.google.com (2025)
- Google Search Central: le funzionalità di intelligenza artificiale e il tuo sito web — developers.google.com (2025)
- btlabs Core

